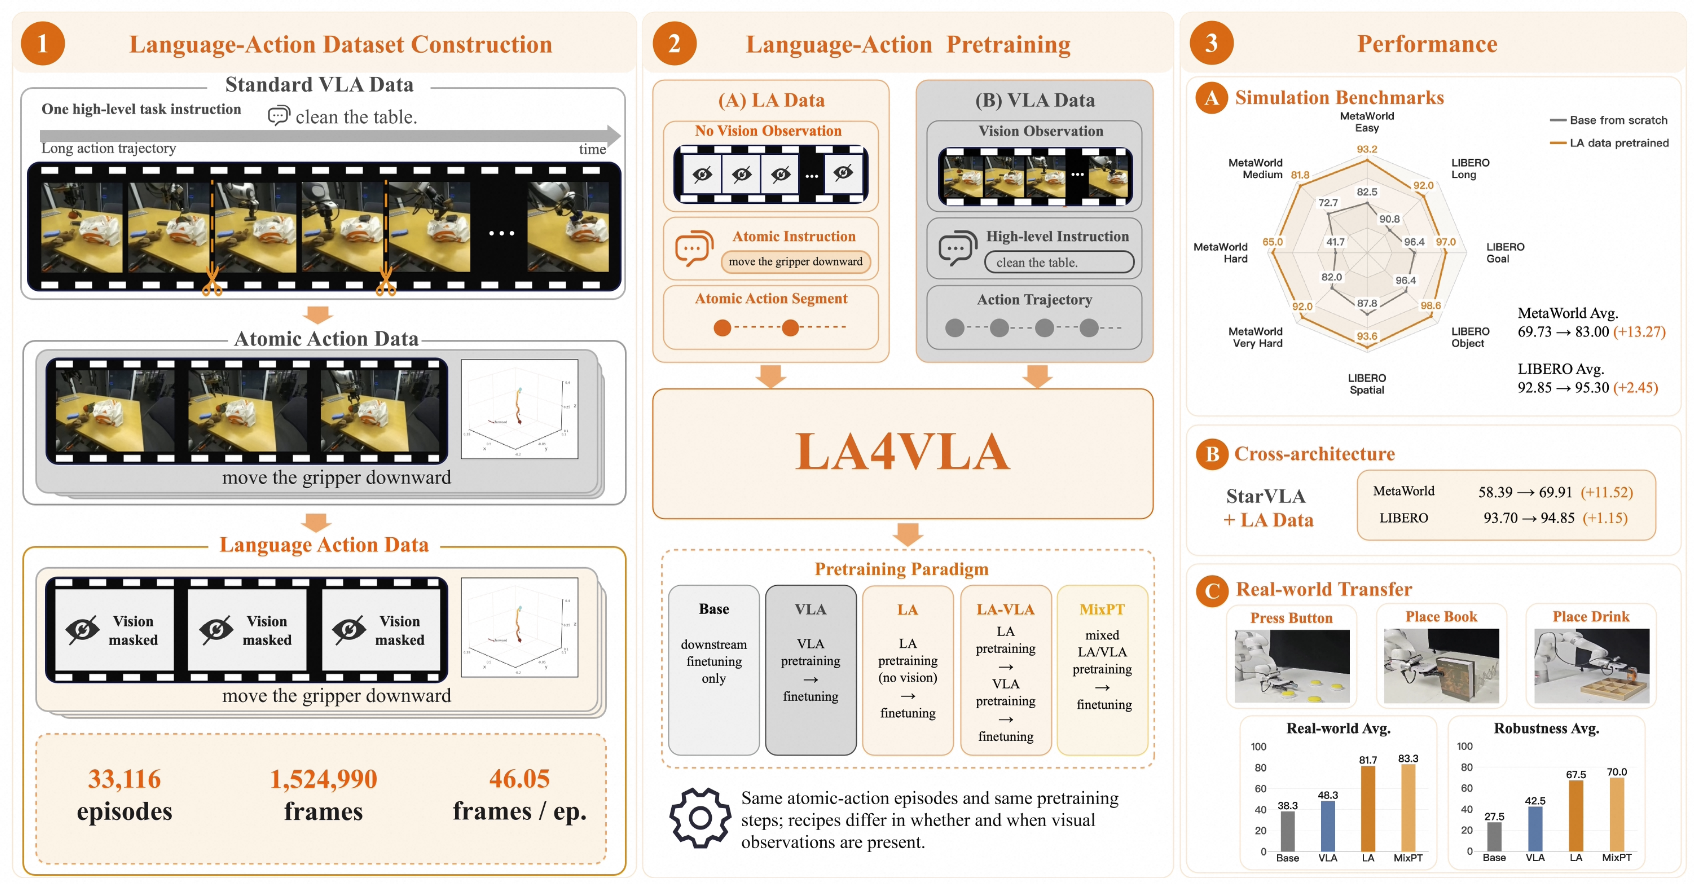
@article{lin2026la4vla,title={LA4VLA: Learning to Act without Seeing via Language-Action Pretraining},author={Lin, Tao and Du, Yuxin and Mao, Yiran and Ye, Zewei and Zhong, Yilei and Cheng, Bing and Wang, Yiming and Liu, Jiting and Tian, Yang and Yan, Junchi and Wu, Feiran and Meng, Zenan and Wei, Hu and Fu, Yuqian and Li, Gen and Zhao, Bo},journal={Alibaba Technology Report},year={2026},}
Evo-Depth: A Lightweight Depth-Enhanced Vision-Language-Action Model
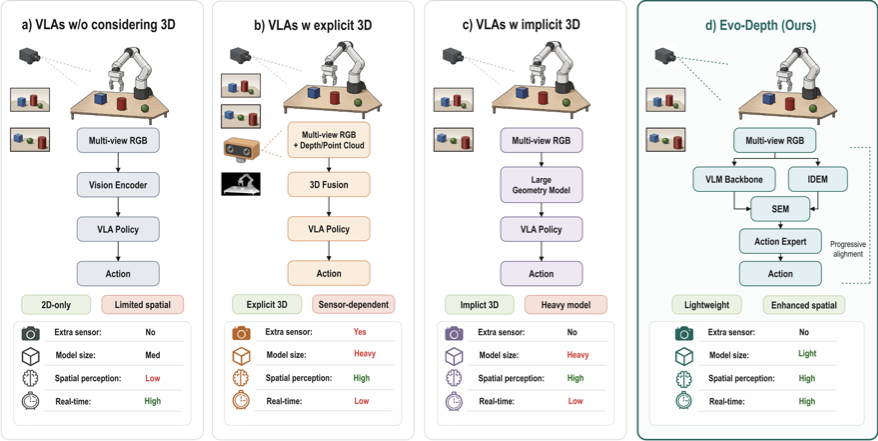
@article{lin2026evodepth,title={Evo-Depth: A Lightweight Depth-Enhanced Vision-Language-Action Model},author={Lin, Tao and Du, Yuxin and Liu, Jiting and Zhu, Nuobei and Li, Yunhe and Fu, Yuqian and Chen, Yinxinyu and Cai, Hongyi and Ye, Zewei and Cheng, Bing and Ye, Kai and Mao, Yiran and Zhong, Yilei and Dong, MingKang and Yan, Junchi and Li, Gen and Zhao, Bo},journal={arXiv preprint arXiv:2605.14950},year={2026},}
Evo-1: Lightweight vision-language-action model with preserved semantic alignment
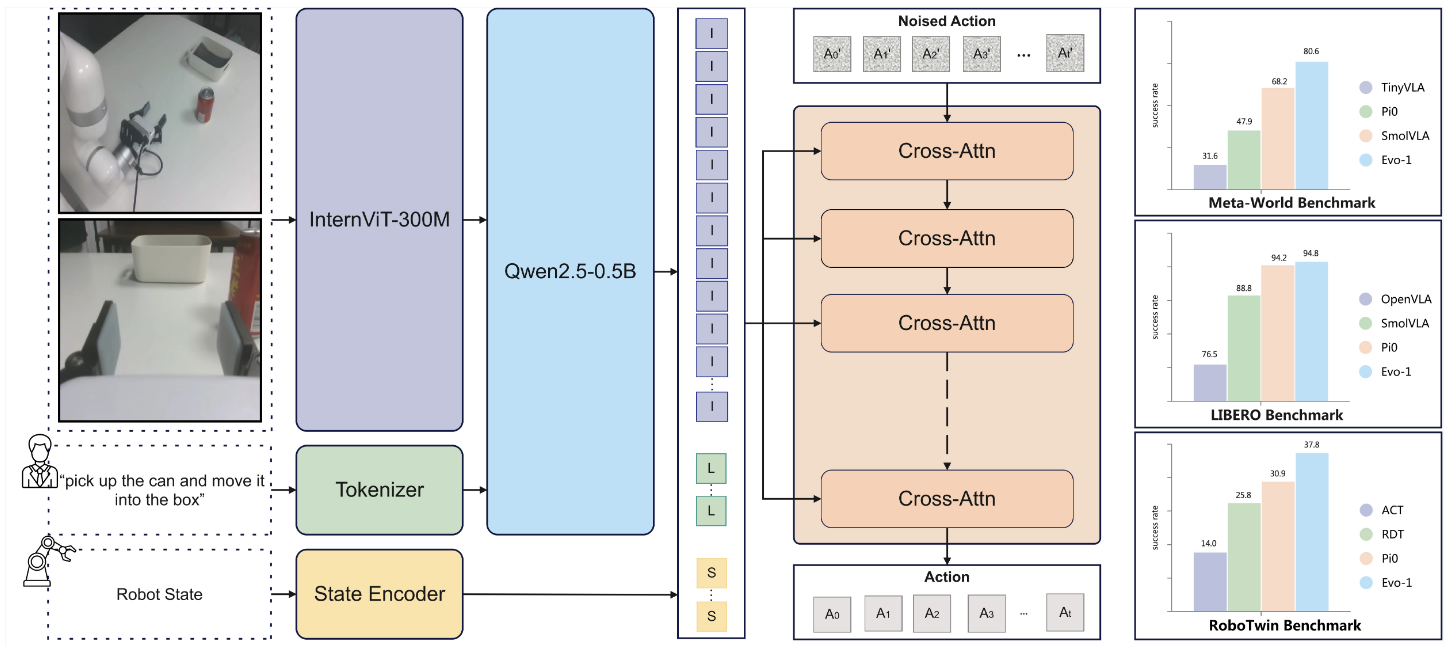
@inproceedings{lin2026evo1,title={Evo-1: Lightweight vision-language-action model with preserved semantic alignment},author={Lin, Tao and Zhong, Y. and Du, Yuxin and Zhang, J. and Liu, J. and Chen, Y. and Gu, E. and Liu, Z. and Cai, H. and Zou, Y.},booktitle={Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition},year={2026},}
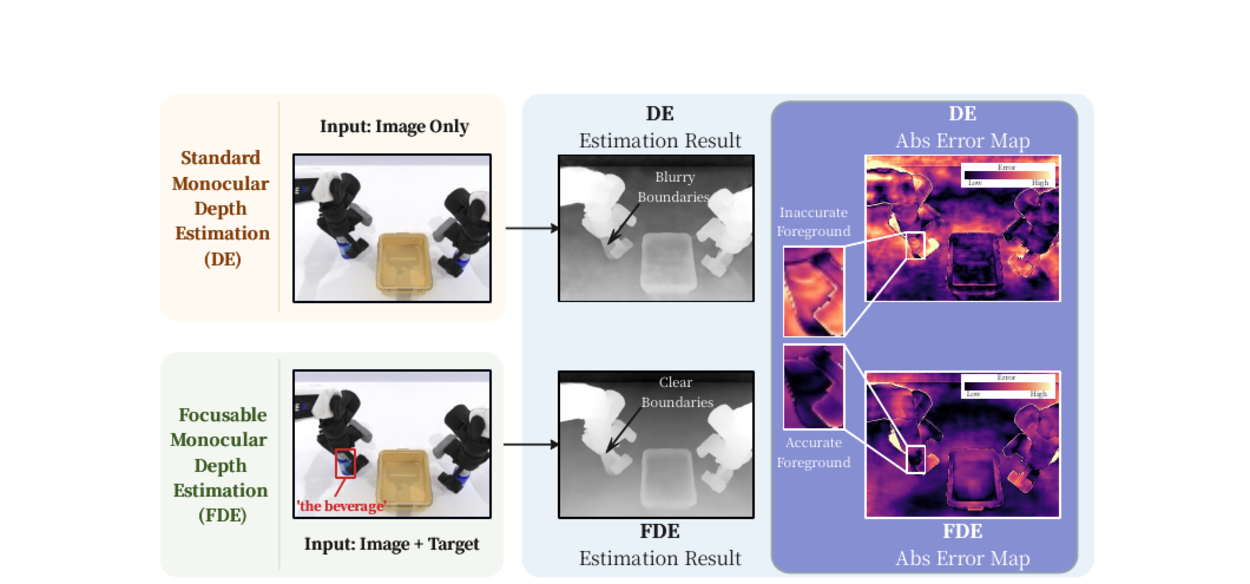
@article{du2026focusable,title={Focusable Monocular Depth Estimation},author={Du, Yuxin and Lin, Tao and Zhong, Zile and Li, Runting and Chen, Xiyao and Liu, Jiting and Liu, Chenglin and Chen, Ying-Cong and Fu, Yuqian and Zhao, Bo},journal={arXiv preprint arXiv:2605.11756},year={2026},}
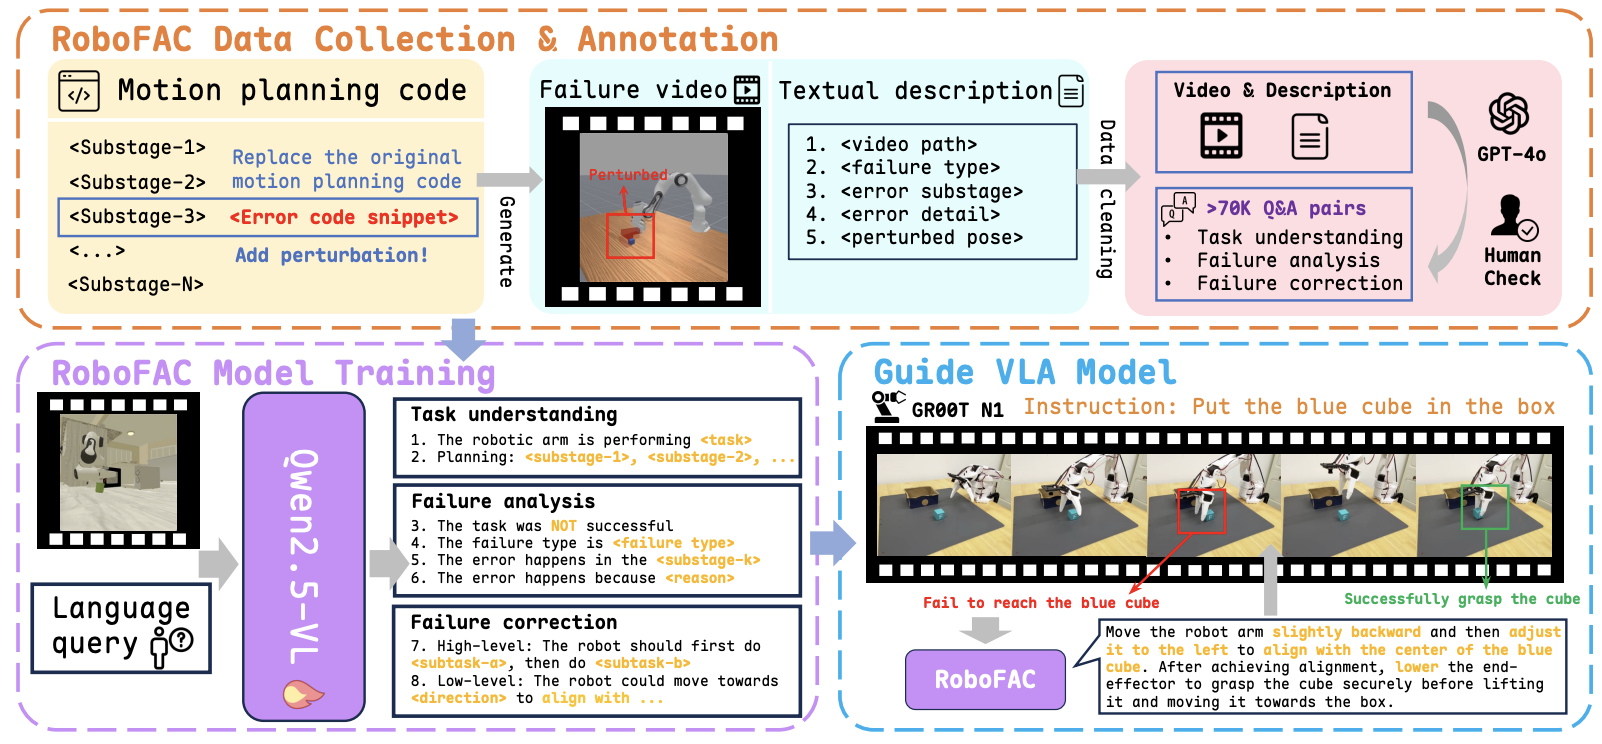
Robofac: A comprehensive framework for robotic failure analysis and correction
Zewei Ye, Weifeng Lu, Minghao Ye, T Lin, and 3 more authors
@inproceedings{ye2026robofac,title={Robofac: A comprehensive framework for robotic failure analysis and correction},author={Ye, Zewei and Lu, Weifeng and Ye, Minghao and Lin, Tao and Yang, Shuo and Yan, Junchi and Zhao, Bo},booktitle={WAICA},year={2026},}
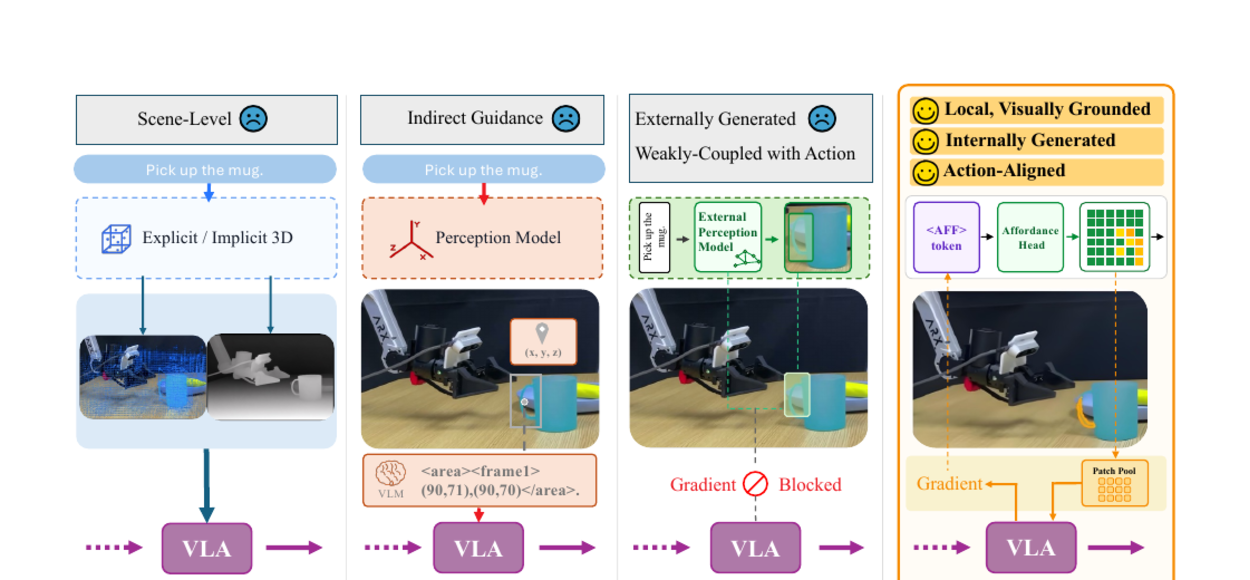
Afford-VLA: Action-Aligned Visual Planning via Internalized Affordance
Runze Wang, Yuqian Fu, Yu Li, T Lin, and 6 more authors
@article{wang2026affordvla,title={Afford-VLA: Action-Aligned Visual Planning via Internalized Affordance},author={Wang, Runze and Fu, Yuqian and Li, Yu and Lin, Tao and Qian, Tianwen and Elhoseiny, Mohamed and Zhao, Bo and Fu, Yanwei and Jiang, Yu-Gang and Xue, Xiangyang},journal={arXiv preprint arXiv:2605.24203},year={2026},}
2025
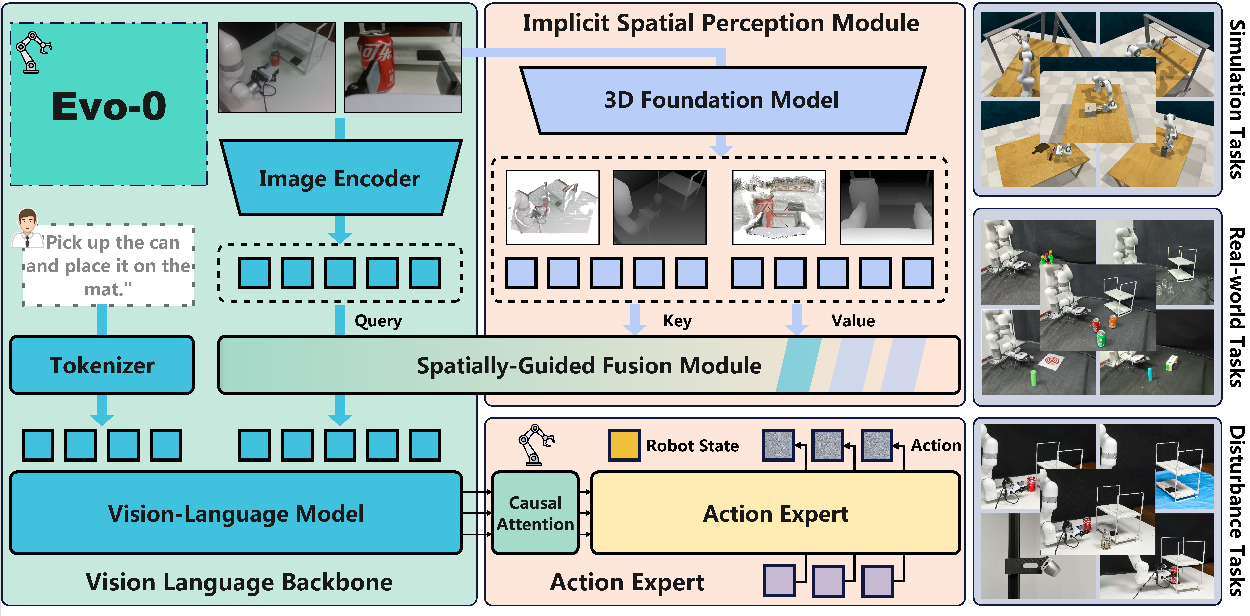
Evo-0: Vision-language-action model with implicit spatial understanding
@article{lin2025evo0,title={Evo-0: Vision-language-action model with implicit spatial understanding},author={Lin, Tao and Li, Gen and Zhong, Y. and Zou, Y. and Du, Yuxin and Liu, J. and Gu, E. and Zhao, B.},journal={arXiv preprint arXiv:2507.00416},year={2025},}
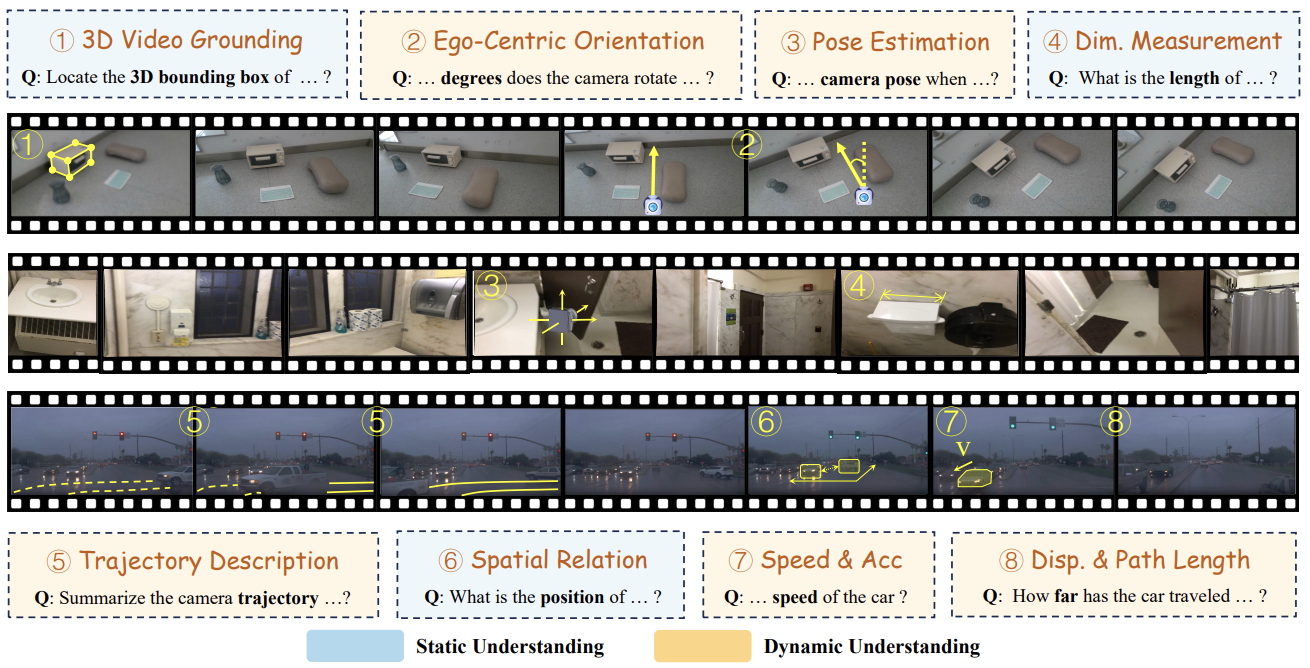
Sti-bench: Are mllms ready for precise spatial-temporal world understanding?
@inproceedings{li2025stibench,title={Sti-bench: Are mllms ready for precise spatial-temporal world understanding?},author={Li, Y. and Zhang, Y. and Lin, Tao and Liu, X. R. and Cai, W. and Liu, Z. and Zhao, B.},booktitle={Proceedings of the IEEE/CVF International Conference on Computer Vision},year={2025},}
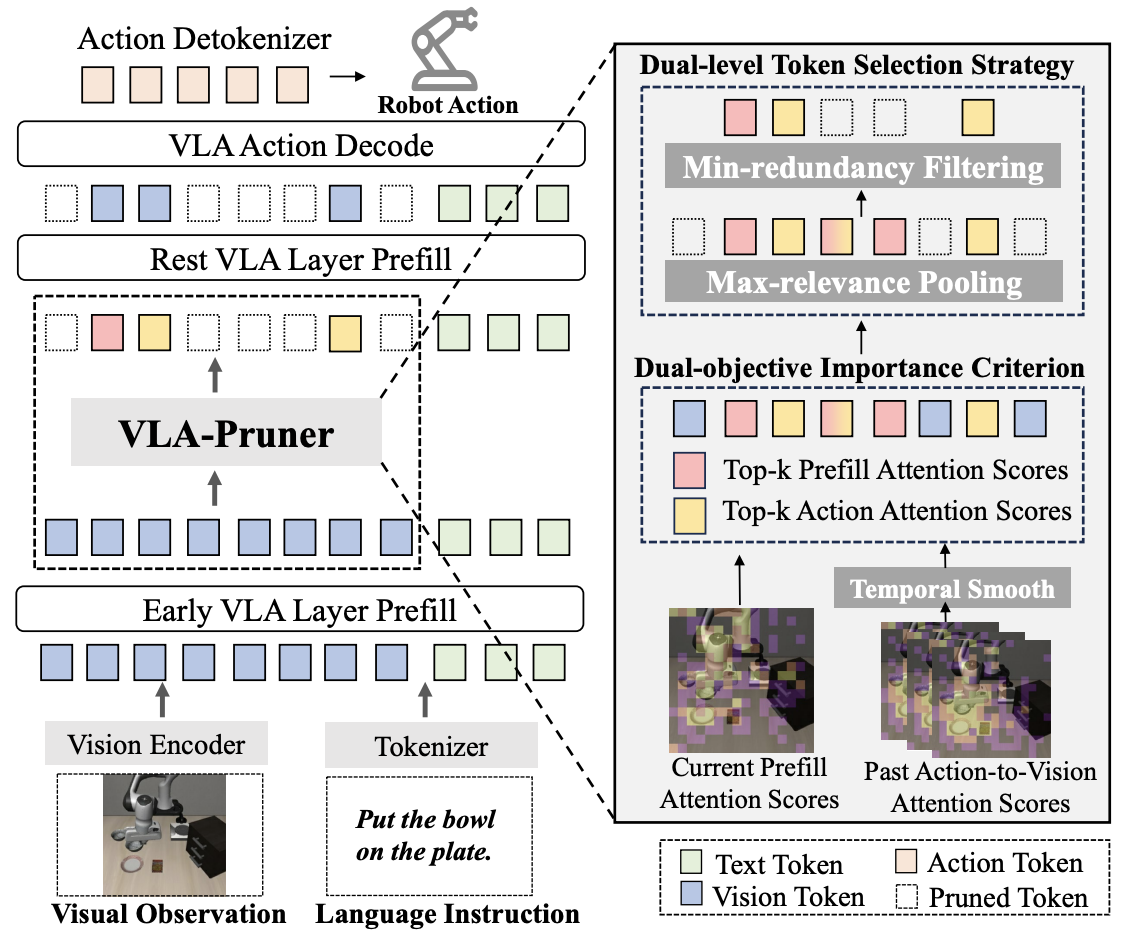
VLA-Pruner: Temporal-Aware Dual-Level Visual Token Pruning for Efficient Vision-Language-Action Inference
Z. Liu, Y. Chen, H. Cai, T Lin, and 3 more authors
@article{liu2025vlapruner,title={VLA-Pruner: Temporal-Aware Dual-Level Visual Token Pruning for Efficient Vision-Language-Action Inference},author={Liu, Z. and Chen, Y. and Cai, H. and Lin, Tao and Yang, S. and Liu, Z. and Zhao, B.},journal={arXiv preprint arXiv:2511.16449},year={2025},}